

本篇目的:學會組合 Pandas 的
cut,pivot_table,groupby功能,輸出自己需求的報表格式
Wafer 檢測數據內會有多個測項。而通常我們在分析 wafer 檢測數據時,會看以下幾種資料
判定該晶粒為正常或異常品
某測項下,各 wafer / lot 的異常顆數與比例
wafer / lot 在某測項的產出分布
兩個相關聯測項的二維產出分布
本篇會針對以上常用情況,組合使用 Pandas 的各項功能輸出報表,節省我們的時間讓我們可以更專注在資料解讀上。
晶粒的出貨前會先經過點測,確認每顆晶粒的能力,並且用事先設定的規則來判定該晶粒等級並分類(或報廢......)。晶粒的分類可分為 Hard bin 與 soft bin,相關說明如下:
Hard bin: 判定晶粒最終的等級(或報廢)。晶粒會依照規格與點測結果判定最終等級,一個晶粒有只會對應到一個 hard bin;就好像米依照外觀顏色被判定為三等米,三等米就是hard bin,且一包米只會有一個等級。
Soft bin: 紀錄該晶粒的詳細狀態。晶粒會依照規格與點測結果判定各能力狀態,一個晶粒會有多個 soft bin;就好像一包米被判定為三等米是因為它同時有太多碎粒與夾雜物,碎粒與夾雜物就是 soft bin,且一包米可以有多個狀態。
| 名稱 | Hard bin | Soft bin |
|---|---|---|
| 定義 | 晶粒最終的等級 | 晶粒的詳細狀態 |
| 晶粒對應 | 一顆晶粒只對應一個,且無法增加 | 一顆晶粒可對應多個,且容易增加 |
| 用途 | 決定晶粒的去向與價格 | 提供詳細晶粒狀態,方便後續工程師做分析 |
要判定晶粒某測項是否正常,我們可以先設定一個跟 data 一樣長的 Series。這個 Series 的目的是跟判定結果(比最小值大 & 比最大值小都要符合)作交集並儲存結果,最後在將此 Series 寫入原本資料中。實際實行方式如下:
先設定SPEC與欄位名稱
# 設定 SPEC 與欄位名稱
target_col = 'Vf2'
min_val = 3.0
max_val = 3.4
new_col_name = target_col + '_fail'
這裡是計算邏輯的部分。Pandas 可以透過 Dataframe[欄位名稱] 的方式讀取指定欄位,而Dataframe[欄位名稱] + 條件判斷式 可以輸出一個都是 boolean 的 Series,因此可以用以下方式取得”比最小值大 & 比最大值小”的交集。
另外最後存入資料的不是 boolean 而是0與1,且在此將"失效"定義為1。這是因為通常我們都是監測失效晶粒,將失效定義為1可以非常方便的計算失效顆數與失效率。
condition前的~可以反轉boolean值
# 判定邏輯 (這是核心部分)
# 先建立一個長度相同、預設全為 True (正常) 的布林序列
# df_a_wafer是一片 wafer 的 dataframe
condition = pd.Series(True, index=df_a_wafer.index)

# 逐一檢查限制,並用 &= (AND) 累積判定結果
if min_val is not None:
    condition &= (df_a_wafer[target_col] >= min_val)

if max_val is not None:
    condition &= (df_a_wafer[target_col] <= max_val)

# 將結果轉換為整數並存回 DataFrame
# 使用 ~condition 將「正常(True)」反轉為「失效(True)」,再轉成 1
df_a_wafer[new_col_name] = (~condition).astype(int)
Hard bin 通常為多個 soft bin 所組成,因此我們可以先用 dict 定義 hard bin 與 soft bin 的關聯。
# 設定 Hard Bin 的分類規則 (定義哪些 Soft Bin 組合成一個 Hard Bin)
# 例如:Po 或 Wd2 任一失效,就歸類為 'under_spec'
hb_condition = {
    'under_spec': ['Po', 'Wd2'],
    'current_leakage': ['Ir1', 'Vf1']
}
fail_suffix = '_fail'
接著建立與上面類似的 Series ,並且裡面的狀態皆為Pass。
# df_a_wafer是一片 wafer 的 dataframe,且裡面已有定義soft bin

# 初始化所有晶粒的狀態為 'Pass'
# 建立一個與數據等長的 Series,預設值皆為良品
die_status = pd.Series('Pass', index=df_a_wafer.index)
接著我們逐一讀取 hb_condition 的內容,並且將指定欄位帶入Dataframe[欄位名稱] 並加上條件判斷式,就可以得到一張欄位對應到 hb_condition 指定欄位、內容為 boolean 的 Dataframe 。因為指定欄位內有任何一個失效就會被分類到指定 hard bin ,因此最後使用 any 並指定方向,就可以以列的方式取聯集。
最後再將聯集結果套入 mask 中,即可將指定 bin 套入。
# 逐項判定 Hard Bin 分類
for bin_name, soft_bin_list in hb_condition.items():
    # 組合出正確的欄位名稱 (例如:Po_fail)
    target_columns = [col + fail_suffix for col in soft_bin_list]

    # 核心邏輯:在指定的欄位中,只要「任一」欄位數值為 1 (any),代表該晶粒符合此失效分類
    # axis="columns" 代表橫向檢查每一列
    # 只針對尚未被判為異常 (仍為 'Pass') 的晶粒進行檢查
    bad_mask = (die_status == 'Pass') &(df_a_wafer[target_columns] == 1).any(axis="columns")

    # 將符合失效條件的晶粒,標記為對應的 bin_name
    die_status[bad_mask] = bin_name

# 將最終判定結果寫回 DataFrame
df_a_wafer['Hard_Bin'] = die_status
針對產出資料,我們除了分 bin 以外,還會想看各片分 bin 結果、平均和標準差等統計值、以及產出分布等報表。以下針對常見之報表提供一系列 code ,可以針對個人需求輸出需要的報表。
對一個整合工程師來說,他不只要知道分bin的結果,還需要知道各個測項的失效率來確認特定製程是否有發生異常。以下code會透過 Pandas 的 Groupby 方法,統整各 wafer 的各項失效顆數與比例。
首先我們要設定想監測的欄位,以及一個都是1的欄位。都是1的欄位可當作"計數器"計算各 wafer 的顆數。
# 假設 df_all_wafer 已經包含了 'Wafer_ID' 以及各項判定結果 (如 Po_fail, Wd2_fail 等)
# 且 1 代表失效,0 代表正常

# 設定我們想要監控的失效欄位清單
monitor_cols = ['Po_fail', 'Wd2_fail']

# 為了方便後續計算總顆數與比例,我們先建立一個計數欄位
df_all_wafer['Count'] = 1
接著我們建立一個 Groupby 物件, Groupby 會依指定的欄位進行分類。再對分類好的元件作加總即可得總失效顆數。
** monitor_cols + ['Count'] → ['Po_fail', 'Wd2_fail', 'Count']
# 核心邏輯:依照 Wafer_ID 分組並加總
# 這裡會得到每一片 Wafer 在各測項的總失效顆數,以及總晶粒數 (Count)
gb_all_wafer = df_all_wafer.groupby(by='Wafer_ID')
df_fail_summary = gb_all_wafer[monitor_cols + ['Count']].sum()
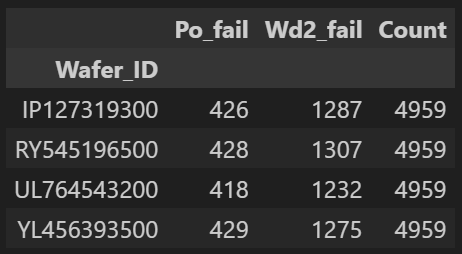
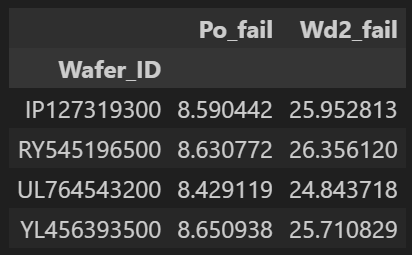
大家看著顆數可能沒什麼概念,但看著失效"率”上升應該都會很緊張。處理失效已經很費心力了,不要再花時間整理數據。因此我們可以透過 Pandas 的 div 方法一次得到每片的失效率,減少作週會報告的時間。
div 內傳入各片顆數的 Series 以及指定運算的方向 (axis=0),即可讓每一片wafer 除以各自的顆數得到失效比例。
# 計算百分比:將失效顆數除以總顆數 (Count)
# 使用 .div 並指定 axis=0 (橫向列對齊),可以一次完成所有欄位的比例計算
df_fail_percent = df_fail_summary[monitor_cols].div(df_fail_summary['Count'], axis=0) * 100
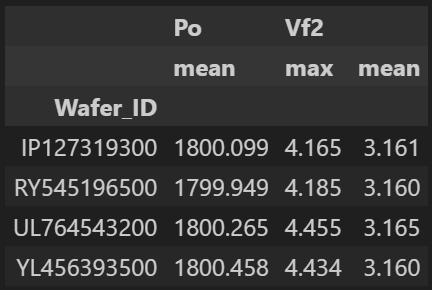
大家一定使用過 Excel 的樞紐分析表來處理 data,當然 Pandas 也有 pivot_table 這樣的功能,且設定邏輯與 excel 相同。在以下的示範中我們先篩選出正常的晶粒 (異常晶粒可能會有偏差值),然後在 aggfunc 中帶入想看的項目,即可得到統計值。
aggfunc的使用方法是{欄名:計算方式},其中計算方式可以以 list 方式傳入多項。另外支援的計算方法可以來這裡看。
# 先用 hard bin 方式篩選正常晶粒
df_good_die = df_all_wafer[df_all_wafer['Hard_Bin'] == 'Pass']

# 製作樞紐分析表,並傳入指定計算方式
# 將wafer id設為index,才能觀看逐片產出
df_good_statistic = pd.pivot_table(df_good_die, index='Wafer_ID', aggfunc={'Vf2':['mean', 'max'], 'Po':'mean'})
在 wafer 檢測數據中,兩個檢測項目之間可能有關連性,例如 LED 晶粒的亮度會與波長相關。若想將某批 lot 的產出,以 (測項A分bin, 測項B分bin, 顆數或佔比) 的方式展開,也可以使用pivot_table功能。
要觀看測項的分布,一定要先將資料分 bin,因此我們可以先建立欄位標籤。
# 假設 df_all_wafer 已經包含了 'Wafer_ID' 以及各項判定結果 (如 Po_fail, Wd2_fail 等)
# 且 1 代表失效,0 代表正常

# 定義兩個維度的切分區間 (以亮度 Po 與波長 Wd2 為例)
po_bin = [0, 1000, 1500, 1700, 1750, 1800, 1850, 2000]
wd2_bin = [0, 442.5, 445, 447.5, 450, 452.5, 455, 457.5, 500]

# 建立易讀的標籤
po_labels = [f'{po_bin[i]}~ {po_bin[i+1]}' for i in range(len(po_bin)-1)]
wd2_labels = [f'{wd2_bin[i]}~ {wd2_bin[i+1]}' for i in range(len(wd2_bin)-1)]

# 設定計數器
df_all_wafer['Count'] = 1
再使用 pd.cut 函數即可分 bin,另外將剛剛製作的標籤帶入 labels= 即可讓欄位標題較易讀。
# 數據分箱:分別對 Po 與 Wd2 進行處理
df_all_wafer['Po_bin'] = pd.cut(df_all_wafer['Po'], bins=po_bin, include_lowest=True, labels=po_labels)
df_all_wafer['Wd2_bin'] = pd.cut(df_all_wafer['Wd2'], bins=wd2_bin, include_lowest=True, labels=wd2_labels)
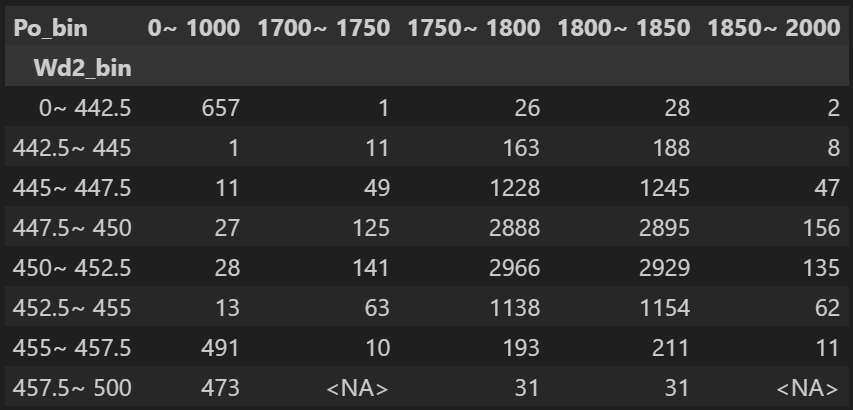
此時因為要同時觀看2個測項,將測項分別帶入 index 與 column,表格裡的值就設定成剛剛新增的 count 欄位 (都是1)。再將 aggfunc 將設定為 count,就會計算同時符合兩個測項區間的晶粒數或佔比。
# 製作二維分布報表:
# 將 Po_bin 設為 index (列),Wd2_bin 設為 columns (欄)
# aggfunc='count' 會計算同時符合這兩個區間的晶粒顆數
df_2d_dist = pd.pivot_table(
    df_all_wafer,
    values='Count',
    index='Wd2_bin',
    columns='Po_bin',
    aggfunc='count'
)
df_2d_dist = df_2d_dist.astype('Int64') # 取整數
另外若想看百分比的話,將各 bin 顆數除以總顆數即可。
# 換算為百分比:將顆數除以總晶粒數,觀察分佈比例
df_2d_percent = (df_2d_dist / df_2d_dist.sum().sum() * 100).round(2)
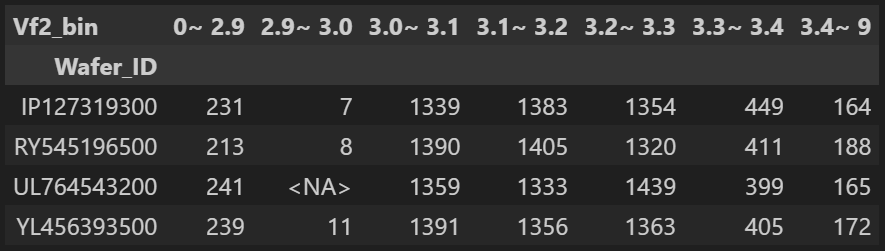
最後大家可以想想看若想得到如下圖的 wafer ID + 測項分bin的報表,可以怎麼設定。
(提示:一樣用pivot_table加設定 index 與 column)
記得存檔,不要讓先前的努力成為泡影


 iThome鐵人賽
 看影片追技術